KI
Einblick in ZetAI Vision: Ein Badminton-Ballwechsel mit 240 Bildern pro Sekunde
Ein Federball verlässt den Schläger mit über 300 km/h. Ihn zu verfolgen, den Schlag zu klassifizieren und die Grenze des Ballwechsels zu erkennen, sind drei Probleme, nicht eines.
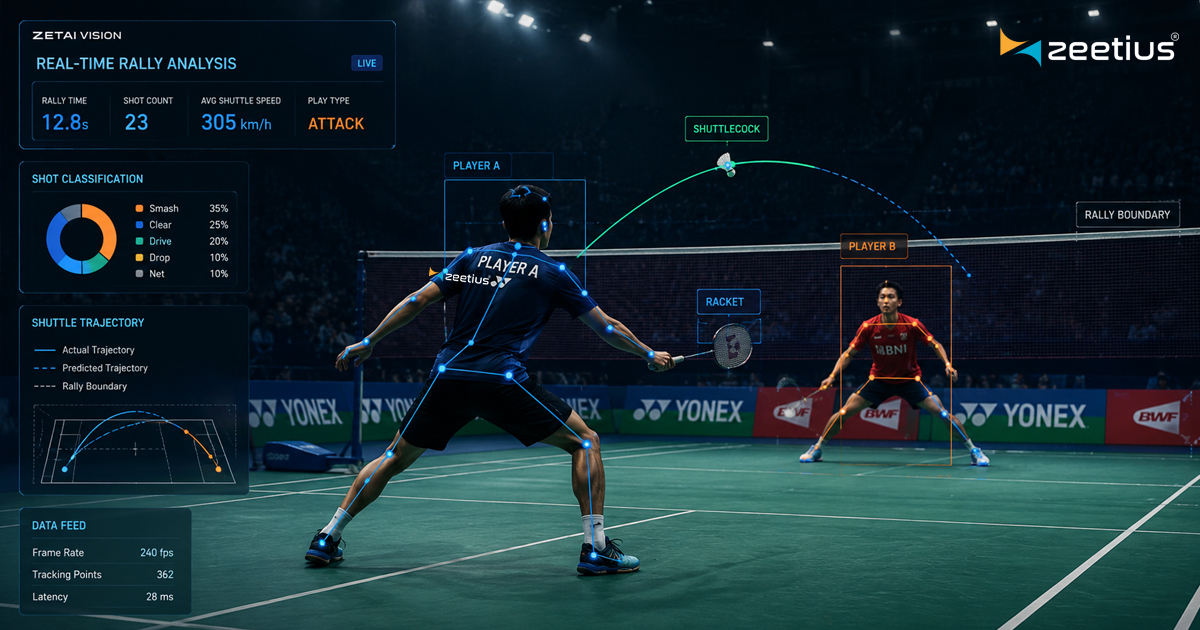
Ein Federball verlässt den Schläger nach einem Smash mit über 300 Kilometern pro Stunde und wird schneller abgebremst als fast jedes andere Objekt im Sport. Bei 30 Bildern pro Sekunde ist er ein Schmierstreifen über zwei Bilder – und dann ist er weg. Daraus lässt sich nichts Brauchbares gewinnen.
Deshalb läuft ZetAI Vision mit 240 fps – und deshalb ist die Bildrate kein technisches Detail, sondern das, worum die gesamte Konstruktion herum aufgebaut ist.
Drei Probleme in einem Mantel
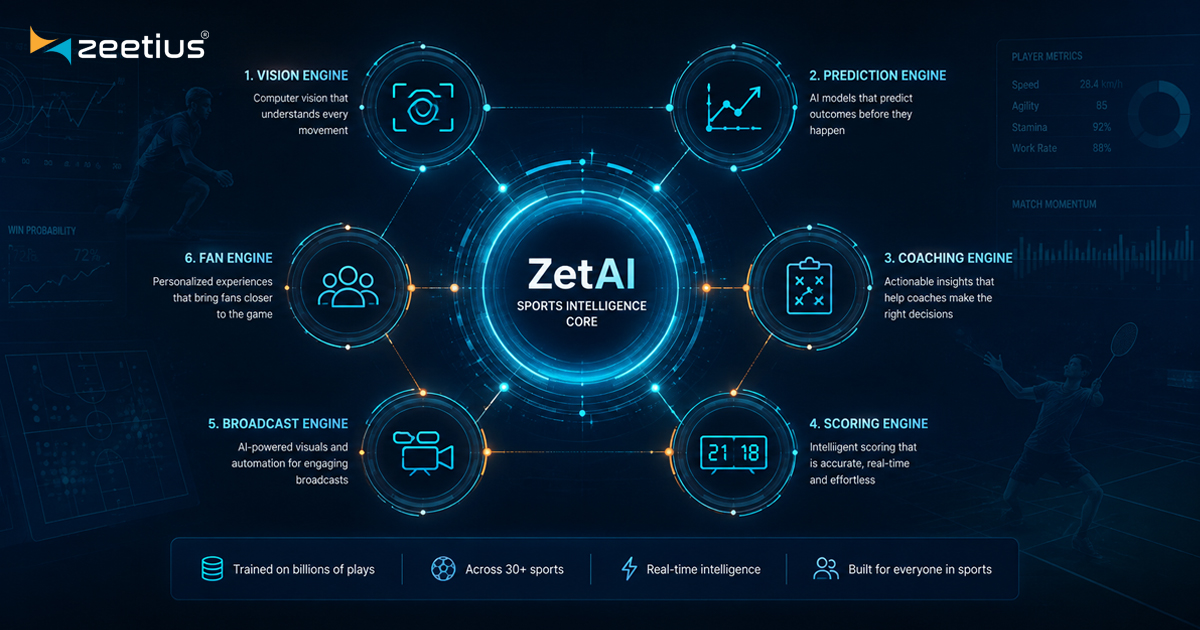
„Computer Vision für den Sport“ klingt nach einer einzigen Fähigkeit. In der Praxis muss ein Ballwechsel in drei Aufgaben zerlegt werden, die fast nichts miteinander gemein haben.
- Erkennung und Tracking – wo sind Spieler, Schläger und Federball in diesem Bild, und wer ist wer über mehrere Bilder hinweg. Räumlich, pro Bild, extrem latenzempfindlich.
- Ereignisklassifizierung – war das ein Smash, ein Drop, ein Clear oder ein Netzschlag? Zeitlich, benötigt ein Fenster aus mehreren Bildern und muss die Absicht ebenso aus der Körperhaltung wie aus der Flugbahn des Balls erkennen.
- Segmentierung – wo endet ein Ballwechsel und wo beginnt der nächste? Strukturell, und die Aufgabe, von der alles Nachgelagerte abhängt, denn eine falsch erkannte Ballwechselgrenze verfälscht jede daraus abgeleitete Statistik.
Die dritte Aufgabe überrascht die Leute. Liegt man bei der Grenze um einen Schlag falsch, verschlechtert sich die Analyse nicht etwas – es verschiebt sich die gesamte Zuordnung, wer welchen Ballwechsel gewonnen hat, und das macht die Mustererkennung vollständig unbrauchbar.
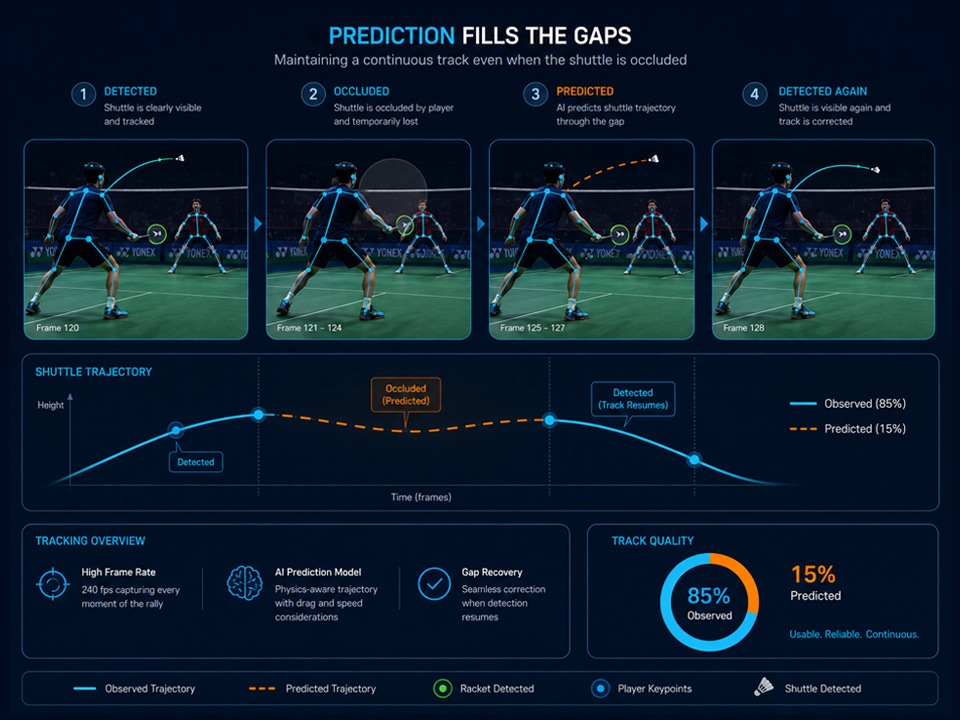
Vorhersage füllt die Lücken
Selbst bei 240 fps geht der Federball gelegentlich verloren – verdeckt durch einen Spieler, vor hellem Hintergrund nicht erkennbar oder im Moment des Treffens schlicht zu schnell. Der Tracker führt ein physikalisches Modell des Federballflugs mit, einschließlich seines ungewöhnlich starken Luftwiderstands, und überbrückt die Lücke per Vorhersage. Sobald die Erkennung wieder einsetzt, korrigiert die beobachtete Position das Modell. Eine Spur, die zu 85 % beobachtet und zu 15 % vorhergesagt ist, ist immer noch eine brauchbare Spur; eine, die bei jeder Verdeckung abreißt, ist es nicht.
Warum Edge-Inferenz und nicht Cloud
240-fps-Video von acht Courts in eine Cloud-GPU hochzuladen, ist in einer Bezirkshalle nicht machbar. Die Bandbreite gibt es nicht, und selbst wo es sie gibt, zerstört der Hin-und-Rück-Weg das Latenzbudget, das Live-Overlays und automatische Wertung überhaupt erst möglich macht.
Die Inferenz läuft deshalb direkt in der Halle, auf Hardware neben den Kameras. Die Modelle sind quantisiert, um das Budget von unter 10 ms auch auf bescheidener Hardware einzuhalten – und was die Halle verlässt, ist kein Video, sondern strukturierte Ereignisse: ein paar hundert Bytes, die beschreiben, was passiert ist, statt Gigabytes, die beschreiben, wie es aussah.
Das ist auch aus einem Grund wichtig, der nichts mit Technik zu tun hat: Rohaufnahmen von Minderjährigen beim Sport sind Daten, die eine Schulturnhalle nicht ohne Not verlassen sollten. Wer am Rand verarbeitet und nur Ereignisse überträgt, kann das Video standardmäßig vor Ort belassen.
Was sie liefert
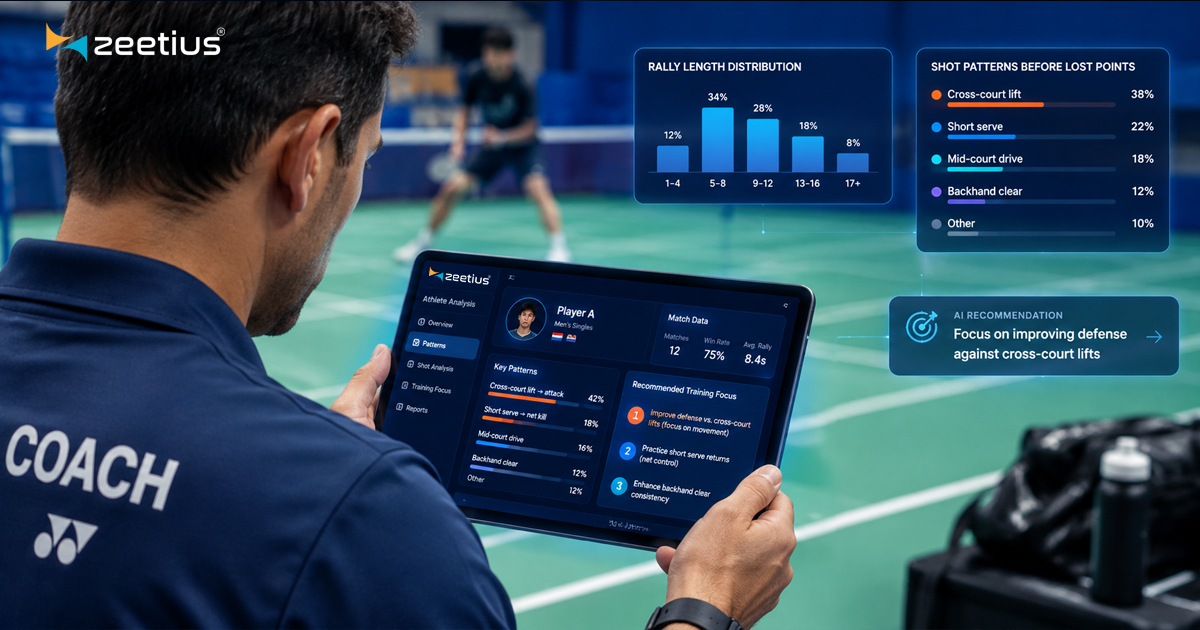
- Rekonstruktion jedes Ballwechsels Schlag für Schlag – jeder Schlag, seine Art, seine Geschwindigkeit und wo er aufkam.
- Heatmaps der Court-Abdeckung – wo ein Athlet tatsächlich seine Zeit verbringt, verglichen damit, wo er glaubt, sie zu verbringen.
- Bewegungs- und Erholungsmuster – wie schnell ein Spieler in die Grundposition zurückkehrt und wie sich das im Spielverlauf verschlechtert.
- Automatische Schlüsselmomente – die langen Ballwechsel und Momentum-Wechsel, aus denen sowohl die Highlight-Erstellung als auch die Spielanalyse schöpfen.
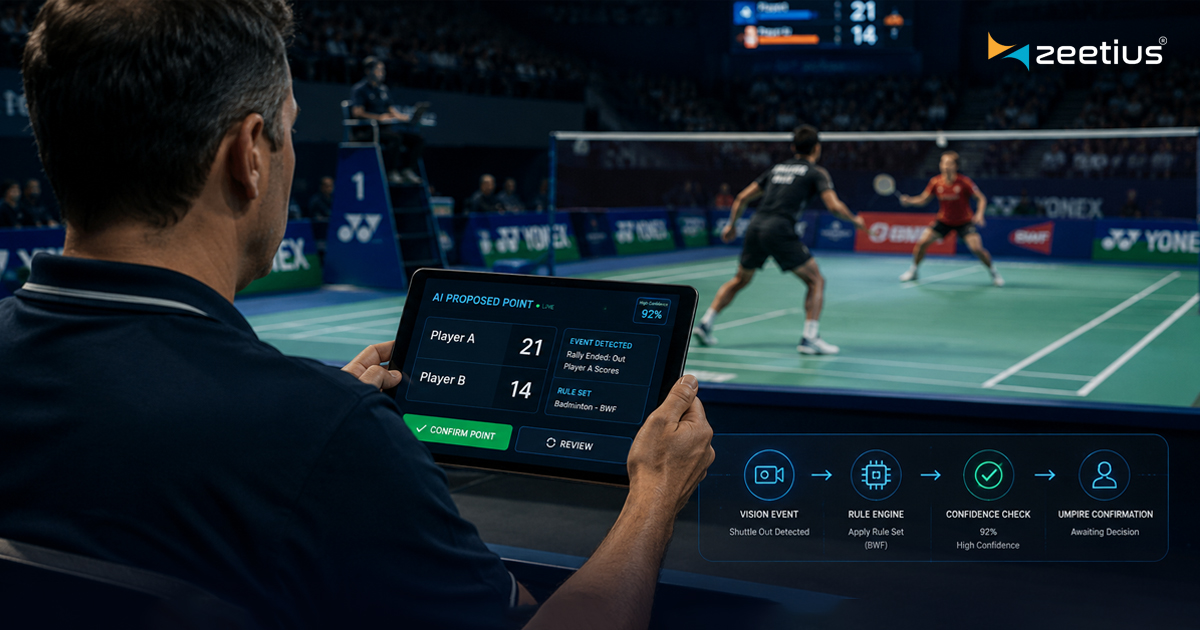
- Scoring-Signale, mit denen ZetAI Score dem Schiedsrichter Punkte vorschlägt.
Ehrliche Grenzen
Die Qualität der Bilderkennung hängt stärker von der Kameraposition ab als von der Modellqualität. Eine einzelne Kamera an einem Ende des Courts liefert brauchbare Ballwechsel-Segmentierung, aber schlechte räumliche Daten; zwei Kameras an gegenüberliegenden Ecken liefern gute räumliche Daten. Das sagen wir lieber vorab, als dass ein Verband ein System kauft und es im zweiten Monat selbst entdeckt.
Das Licht spielt eine enorme Rolle – in einer Halle mit einer Mischung aus Tageslicht und Leuchtstoffröhren entsteht bei hohen Bildraten ein Flackern, das ausgeglichen werden muss. Und die Modelle sind in den Racket-Sportarten am stärksten, wo wir die meisten annotierten Daten haben, und dünner in Sportarten, die wir erst kürzlich aufgenommen haben. Diese Lücke schließt sich mit der Nutzung, aber heute ist sie real.